


Tip
Yet Another Key-Value Database...
- Студент:
Барсуков Максим Андреевич - Группа:
P3315 - ИСУ:
367081 - Функциональный язык:
Elixir
Цель: получить навыки работы со специфичными для выбранной технологии/языка программирования приёмами.
- программа должна быть реализована в функциональном стиле;
- требуется использовать идиоматичный для технологии стиль программирования;
- задание и коллектив должны быть согласованы;
- допустима совместная работа над одним заданием.
- титульный лист;
- требования к разработанному ПО, включая описание алгоритма;
- реализация с минимальными комментариями;
- ввод/вывод программы;
- выводы (отзыв об использованных приёмах программирования).
см. README проекта
-
Размещение нескольких «состояний» в кластере
-
Автоматическая балансировка нагрузки, разумная масштабируемость
-
Поддержка линеаризуемой семантики т. е. клиентские операции над «состоянием» обрабатываются атомарно в заданном порядке.
-
Недопустимо
- потерять все подтвержденные записи
- дублировать записи из-за повторной попытки клиента
-
Толерантность к ошибкам меньшинства членов консенсусной группы
-
Сохранение данных для восстановления после сбоя
- периодическая очистка ненужных данных на диске
-
Автоматическое восстановление после некритического сбоя узла
-
Гибкая модель данных для «состояния»
Кратко: Запуск и управление несколькими консенсусными группами в кластере
-
- репликация и распределенная транзакция
- таблица и запись (кортеж), данные реплицируются на основе таблицы
- большое и тяжелое; восстановление после сбоя затруднено (насколько мне известно)
-
- (улучшенный вариант) алгоритма консенсуса Paxos
- специализируется на операциях с ключом и значением
- по сути, часть Riak, а не отдельная библиотека
- Предоставляет линеаризуемую семантику для операций с реплицируемым значением.
- Реализует конечный автомат на основе памяти с дополнительным сохранением (запись журналов, создание снимков с уплотнением журналов, восстановление состояния из снимков и файлов журналов).
- Гибкая модель данных: копирование произвольной структуры данных
- Поддерживает изменения членства:
- добавление/удаление участника
- замена лидера
- Каждый член консенсусной группы реализован как процесс
:gen_statem. - Произвольная структура данных может быть реплицирована между членами
- Команды должны быть чистыми
- в журналы Raft включается только минимальная информация
- нечистые операции можно выполнять в обратных вызовах
RadishDB.Raft.Communication.LeaderHook
start_link/2- Процесс консенсуса участников запускается двумя способами:
- стать лидером недавно созданной консенсусной группы
- стать последователем существующей консенсусной группы
- во избежание состояния гонки нескольких лидеров
- вопрос «существует ли консенсусная группа или нет» должен обрабатываться вызывающей стороной
- Процесс консенсуса участников запускается двумя способами:
- Основным компонентом является модуль
RadishDB.Raft.RPCServer.:gen_statemс 3 состояниями:leader,candidate,follower.- необходимо обрабатывать 19 типов событий => 57 обработчиков для реализации
- Для линеаризуемости
- назначить уникальный идентификатор каждой команде
- ответы на выполнение команд кэшируются
- если для команды найден кеш, не выполняйте команду, а просто верните кешированный ответ
- По сути, это эквивалентно неявному установлению клиентского сеанса для каждого запроса.
- (Довольно глупые) ошибки, обнаруженные во время тестирования
- ошибка сохранения поля структуры:
%S{f: v}вместо%S{s | е: в} - забыл сбросить таймер
- ошибка при оценке большинства
- и т. д.
- ошибка сохранения поля структуры:
Библиотека Elixir для запуска нескольких консенсусных групп Raft в кластере ErlangVM.
- Простое хранение нескольких «состояний всего кластера»
- Децентрализованная архитектура и отказоустойчивость
- Разумно масштабируемое размещение процессов для нескольких консенсусных групп
Raft.- Процессы-члены консенсуса распределяются по ErlangVM с учетом центров обработки данных с использованием рандеву-хеширования.
- Автоматическая ребалансировка при добавлении/удалении узлов
- Прозрачность местоположения
- Каждый лидер консенсусной группы доступен по имени (атому) консенсусной группы.
- Фактические идентификаторы процессов-лидеров консенсуса кэшируются в локальной таблице ETS для быстрого доступа.
Ниже приведены общие рекомендации для запуска RadishDb в кластере ErlangVM.
- Кластер должен состоять как минимум из 3 узлов, чтобы обеспечить возможность отказа одного узла. Аналогично, узлы кластера должны охватывать 3 (или более) центра обработки данных, чтобы система продолжала функционировать даже в случае сбоя одного центра обработки данных.
- Когда вы добавляете новые узлы ErlangVM, каждый узел должен выполнить следующие шаги инициализации:
- устанавливать соединения с другими работающими узлами,
- вызывать
RadishDB.ConsensusGroups.GroupApplication.activate/1.
- При завершении работы узла вам следует действовать следующим образом (хотя RadishDB допускает сбои, пока сохраняется кворум, гораздо лучше сообщить RadishDB о необходимости заранее подготовиться):
- вызовите
RadishDB.ConsensusGroups.GroupApplication.deactivate/0внутри завершаемого узла, - подождите некоторое время (скажем, 10 минут), чтобы существующие члены консенсусной группы были перенесены на другие узлы, затем
- наконец выключите узел.
- вызовите
-
Схема именования процессов
- Использовать атом в качестве идентификатора консенсусной группы
- члены группы консенсуса зарегистрированы с одним и тем же атомом
- это значительно упрощает отслеживание того, где находятся члены консенсуса.
- Использовать атом в качестве идентификатора консенсусной группы
-
Мотивация использования Rendezvous hashing
- нужно назначить участников каждому узлу
- добавление/удаление узла запускает ребалансировку
- например 100 процессов в 4 узлах => 5 узлов
a: 24, b: 27, c: 23, d: 26a: 19, b: 23, c: 18, d: 21, e: 19
- например 100 процессов в 4 узлах => 5 узлов
- нельзя мигрировать множество процессов
- в идеале нужно перенести только
1/n_nodesпроцессов - простое использование
modприводит к очень плохим результатам
- в идеале нужно перенести только
- Алгоритм
- сортировать элементы, используя «случайный вес» (хэш-значение)
- брать членов с наименьшим весом
- По сравнению с последовательным хешированием, рандеву-хеширование
- намного проще
- естественно интегрирует размещение с учетом центра обработки данных
-
Отказоустойчивость
- Мы не можем доверять удаленному общению
- например создание нового лидера происходит локально, так как это нужно сделать ровно один раз
- Особенно избегаем синхронного удаленного обмена сообщениями
- API супервизора синхронен
- не вызываем API-интерфейсы супервизора с другого узла; вместо этого следует передать информацию процессу-менеджеру целевого узла и попросить вызвать его
- Мы не можем доверять удаленному общению
-
Сохранение консистентности
- Запускаем периодические проверки членов консенсуса
- добавить недостающий элемент, удалить лишний элемент, заменить лидера элементом в нужном узле
- чтобы избежать разногласий, каждый узел управляет консенсусными группами, лидеры которых, как ожидается, будут находиться на этом узле.
- Попробуйте повторно подключиться к другим узлам, чтобы восстановиться после временного сетевого разделения.
- Узлы, которые были отключены некоторое время, очищаются (для обработки более длительных сбоев).
- Запускаем периодические проверки членов консенсуса
Проектирование процесса - примерно то же, что и в riak_ensemble:
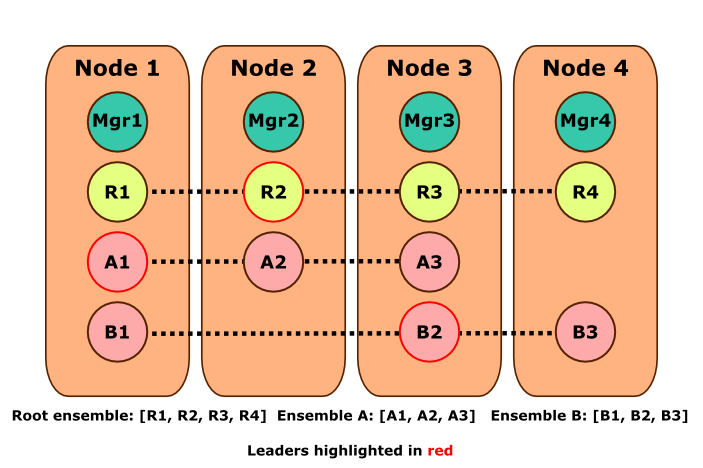
1. Склонировать репозиторий:
git clone git@github.com:maxbarsukov/radish-db.git2. Установить зависимости:
mix deps.get
mix deps.compile
3. Линтинг:
mix check4. Тестирование:
mix test --trace5. Запустить приложение:
$ iex --sname 1 -S mix
iex(1@laptop)>Предположим, у нас есть кластер из 4 узлов Erlang:
$ iex --sname 1 -S mix
iex(1@laptop)>

$ iex --sname 2 -S mix
iex(2@laptop)> Node.connect(:"1@laptop")

$ iex --sname 3 -S mix
iex(3@laptop)> Node.connect(:"1@laptop")

$ iex --sname 4 -S mix
iex(4@laptop)> Node.connect(:"1@laptop")
Загрузим следующий модуль, который реализует поведение RadishDB.Raft.StateMachine.Statable на всех узлах кластера:
  defmodule JustAnInt do
    @behaviour RadishDB.Raft.StateMachine.Statable
    def new, do: 0
    def command(i, {:set, j}), do: {i, j}
    def command(i, :inc), do: {i, i + 1}
    def query(i, :get), do: i
  end
Вызвать RadishDB.ConsensusGroups.GroupApplication.activate/1 на всех узлах:
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.activate("zone1")

iex(2@laptop)> RadishDB.ConsensusGroups.GroupApplication.activate("zone2")

iex(3@laptop)> RadishDB.ConsensusGroups.GroupApplication.activate("zone1")

iex(4@laptop)> RadishDB.ConsensusGroups.GroupApplication.activate("zone2")
Создадим 5 консенсусных групп, каждая из которых реплицирует целое число и имеет 3 консенсусных члена:
iex(1@laptop)> config = RadishDB.Raft.Node.make_config(JustAnInt)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.add_consensus_group(:consensus1, 3, config)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.add_consensus_group(:consensus2, 3, config)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.add_consensus_group(:consensus3, 3, config)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.add_consensus_group(:consensus4, 3, config)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.add_consensus_group(:consensus5, 3, config)
Теперь мы можем выполнить запрос/команду с любого узла кластера:
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.query(:consensus1, :get)
{:ok, 0}

iex(2@laptop)> RadishDB.ConsensusGroups.GroupApplication.command(:consensus1, :inc)
{:ok, 0}

iex(3@laptop)> RadishDB.ConsensusGroups.GroupApplication.query(:consensus1, :get)
{:ok, 1}
Активация/деактивация узла в кластере запускает перебалансировку процессов-членов консенсуса.
Группа консенсуса из 3 человек продолжает работать, если один из них умирает (даже без деактивации):
iex(3@laptop)> :gen_statem.stop(:baz)
iex(1@laptop)> RadishDB.ConsensusGroups.GroupApplication.query(:consensus1, :get)
{:ok, 1}В рамках данной работы были применены инструменты:
- ExUnit - для модульного тестирования;
- Credo - инструмент статического анализа кода для языка Elixir;
- Dialyxir - Dialy
zerxir is a DIscrepancy AnaLYzer forERlangEliXIR programs.
В ходе выполнения лабораторной работы я познакомился с алгоритмом консенсуса Raft и реализовал его с нуля на Elixir, поработал с кластеризацией и node-to-node коммуникацией в ErlangVM, узнал много нового об OTP и мониторинге Elixir приложений, научился тестировать распределенные Elixir приложения.
| Ссылка | Описание |
|---|---|
| elixirschool.com/otp_distribution | OTP distribution |
| raft.github.io | Raft Consensus Algorithm |
| raft.github.io/raft.pdf | In Search of an Understandable Consensus Algorithm (Extended Version) |
| tikv.org/deep-dive/scalability/multi-raft | Multi-raft |
| habr.com/ru/articles/469999/ | Как сервера договариваются друг с другом: алгоритм распределённого консенсуса Raft |
| thesecretlivesofdata.com/raft/ | Интерактивная демонстрация Raft |
| en.wikipedia.org/wiki/Raft_(algorithm) | Raft на Wikipedia |
| eli.thegreenplace.net/2024/implementing-raft | Реализация Raft на Go |
Проект доступен с открытым исходным кодом на условиях Лицензии MIT.
Авторские права 2025 Max Barsukov
Поставьте звезду ⭐, если вы нашли этот проект полезным.